Le bulletin s’ouvre, la roue tourne, et tout le monde accuse « le réseau ». Je regarde d’abord le nombre de requêtes. Une classe de trente élèves qui charge les notes une par une, ce n’est pas un réseau lent. C’est trente allers-retours qu’on a écrits nous-mêmes.
Le piège, écrit clairement
Cette vue a l’air honnête. Elle ne l’est pas.
from django.http import JsonResponse
from app.models import Eleve

def bulletins(request):
    lignes = []
    for eleve in Eleve.objects.all():
        lignes.append({
            "nom": eleve.nom,
            "notes": list(eleve.notes.values("matiere", "valeur")),
        })
    return JsonResponse({"lignes": lignes})
Eleve.objects.all() est une requête. eleve.notes à l’intérieur de la boucle en pose une autre, à chaque tour. Trente élèves, trente et une requêtes. Trois cents élèves, le même code, trois cent une requêtes. La page n’a pas changé. Le coût, si.
Une lecture, pas une boucle d’allers
prefetch_related va chercher les notes en une deuxième requête, puis les rattache en mémoire. Le nombre ne dépend plus de la taille de la classe.
def bulletins(request):
    eleves = Eleve.objects.prefetch_related("notes").order_by("nom")
    lignes = [
        {
            "nom": eleve.nom,
            "notes": [
                {"matiere": note.matiere, "valeur": note.valeur}
                for note in eleve.notes.all()
            ],
        }
        for eleve in eleves
    ]
    return JsonResponse({"lignes": lignes})
eleve.notes.all() ici ne retourne plus en base. Il lit ce qui a déjà été ramené. Si vous remettez un filtre Django dans cette boucle, vous repercez le trou.
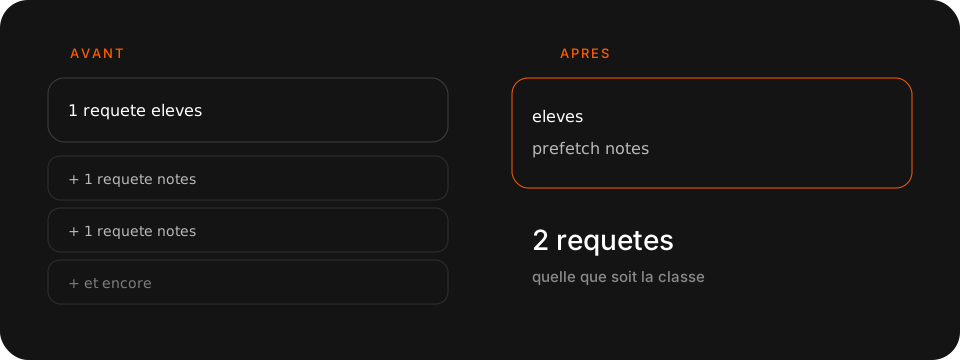
Exemple
Classe de 30, 4 notes chacun.
- Avant : 1 + 30 = 31 requêtes, et la page attend la dernière.
- Après : 2 requêtes, élèves puis notes, quel que soit l’effectif.
Le JSON renvoyé ne change pas. Seul le chemin change. C’est le critère : même réponse, moins d’allers.
Compter avant d’optimiser ailleurs
python manage.py shell -c "
from django.db import connection, reset_queries
from app.models import Eleve
reset_queries()
list(Eleve.objects.prefetch_related('notes'))
print(len(connection.queries))
for requete in connection.queries:
    print(requete['sql'][:120])
"
Je veux voir 2, pas 31. Si le chiffre reste haut, j’ouvre le plan PostgreSQL sur la requête la plus longue, pas un cache devant le symptôme.
python manage.py dbshell -c "EXPLAIN ANALYZE SELECT id, nom FROM app_eleve ORDER BY nom;"Un index sur nom se justifie quand ce plan trie toute la table. Pas avant de l’avoir lu.